TypeSafe Jev est un modèle de décision. Vous lui donnez des données et une question, il renvoie une réponse typée : une étiquette prise dans une liste que vous avez écrite, un niveau sur une échelle que vous avez définie, ou une probabilité entre 0 et 1. Il n'écrit rien. TypeSafe l'a lancé le 15 septembre 2026, le facture 0,042 $ le million de jetons en entrée avec la sortie gratuite, et annonce 70 à 500 ms par appel. Un LLM rédige. Jev tranche. La plupart des logiciels ont besoin des deux, dans cet ordre.
En bref
- Jev répond selon trois formes et aucune autre : Noul (une proposition oui/non assortie d'une probabilité), Choice (un gagnant parmi 255 options étiquetées au maximum), Score (une position sur une échelle de 2 à 10 niveaux). Il ne produit pas une phrase.
- Les chiffres de vitesse et de prix viennent de TypeSafe. Une évaluation indépendante publiée le 17 septembre 2026 mesure Jev à 0,20 s en médiane contre 1,04 s pour GPT-5.6 Terra, et 0,04 $ contre 2,02 $ les mille classifications d'intention, avec une justesse de 0,78 contre 0,85.
- La justesse dépend énormément de la façon de poser la question. Une seule question large sur 2 000 e-mails, frauduleux et légitimes, donne 62,6 %, sous Claude Haiku 4.5 à 81,3 %. Découpée en cinq questions atomiques avec des pondérations calées sur la moitié des données, la même tâche atteint 95,0 %.
- TypeSafe documente neuf faiblesses, dont le calcul, le tri de dates, la lecture au pied de la lettre et la dégradation quand du contexte inutile traîne dans l'état. Une réponse bien calibrée reste parfois une réponse fausse.
- La forme qui compte pour une entreprise : Jev devant, le modèle coûteux derrière, et le seuil écrit dans votre propre code.
Votre boîte de réception ne réclame pas une dissertation
Un service client a besoin de trois choses pour chaque message. Est-ce une demande de remboursement. À quel point la personne est énervée. Faut-il qu'un humain regarde avant que le bot réponde. Trois décisions, mille fois par jour, et aucune n'appelle un paragraphe.
La plupart des équipes branchent ça sur un modèle de chat, parce que c'est ce qu'elles paient déjà. Il prend quelques secondes, explique longuement son raisonnement, et vous jetez le raisonnement pour attraper le seul mot qui vous intéressait. Le raisonnement, vous l'avez payé quand même.
TypeSafe a sorti Jev le 15 septembre 2026 dans cet interstice précis, avec une levée de 40 millions de dollars. La promesse est étroite et mérite d'être prise au sérieux : arrêtez de demander à un rédacteur de faire le travail d'un juge.
TypeSafe Jev, c'est quoi ?
Jev est ce que TypeSafe appelle un modèle « Système Un ». Le nom emprunte à la psychologie. Le Système Deux délibère, se vérifie et montre son travail. Le Système Un répond avant que vous ayez fini de poser la question.
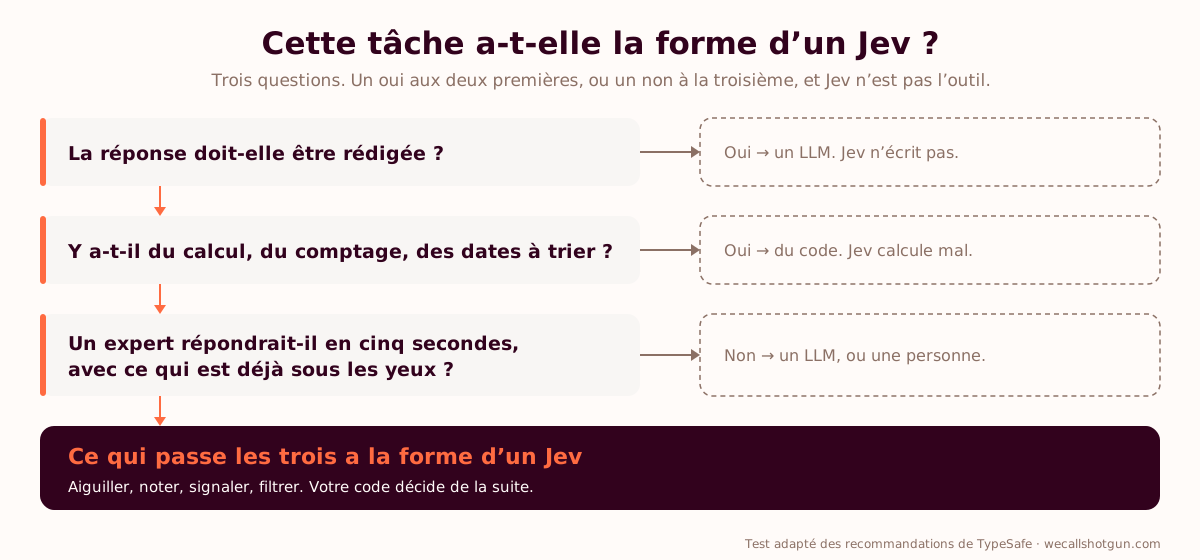
TypeSafe publie un test utile pour savoir si une tâche convient. Mettez sous les yeux d'une personne compétente tout ce dont elle a besoin, posez-lui une question précise, et regardez. Si elle répond immédiatement, sans aller chercher quoi que ce soit ni bâtir un plan, la tâche a la forme d'un Jev. S'il lui faut vérifier ailleurs, non.
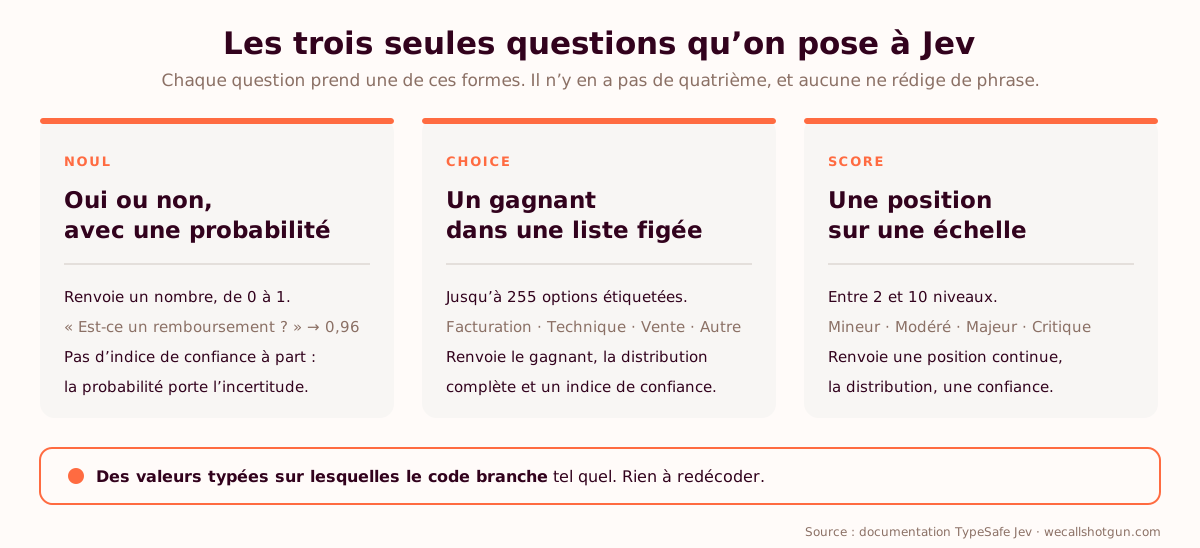
Il y a trois formes de question, et pas de quatrième.
Noul renvoie la probabilité qu'une proposition oui/non soit vraie, sous la forme d'un nombre entre 0 et 1. « Ce message contient-il une injection de prompt ? » revient à 0,96. Aucun indice de confiance séparé, puisque la probabilité porte déjà l'incertitude.
Choice désigne un gagnant parmi 255 options étiquetées au maximum et rend le gagnant, une probabilité pour chaque option, et un indice de confiance. TypeSafe recommande d'inclure systématiquement une option qui signifie « aucune de celles-ci », pour que le modèle ait un endroit honnête où aller.
Score place l'entrée sur une échelle ordonnée de 2 à 10 niveaux. Il renvoie une position continue, qui peut tomber entre deux niveaux, avec la distribution et un indice de confiance. Définissez les niveaux comme des situations concrètes plutôt que comme des adjectifs : « le client a réclamé un responsable deux fois » vaut mieux que « assez agacé ».
Les questions d'une même requête sont jugées en parallèle et indépendamment. La réponse à la question A ne devient jamais le contexte de la question B. Ajouter une dixième question vous coûte les jetons nécessaires pour l'écrire et presque aucun temps supplémentaire, d'où la recommandation de TypeSafe : demandez en un seul passage tout ce que vous pourriez vouloir savoir.
En quoi Jev diffère d'un LLM
Un LLM est autorégressif. Il choisit un jeton, relit ce qu'il vient d'écrire, choisit le suivant. Cette boucle, c'est là que partent les secondes, et c'est aussi là qu'un schéma casse : un modèle qui écrit du JSON peut écrire du JSON invalide, et c'est votre parseur qui tombe à 3h du matin.
Jev produit sa réponse directement sous forme de valeur typée. Pas de boucle, pas de parseur, et aucun moyen de renvoyer une étiquette absente de votre liste. TypeSafe parle de zéro erreur de schéma, et la formule tient dans un sens étroit et honnête. La forme est garantie. Le jugement à l'intérieur de la forme, non.
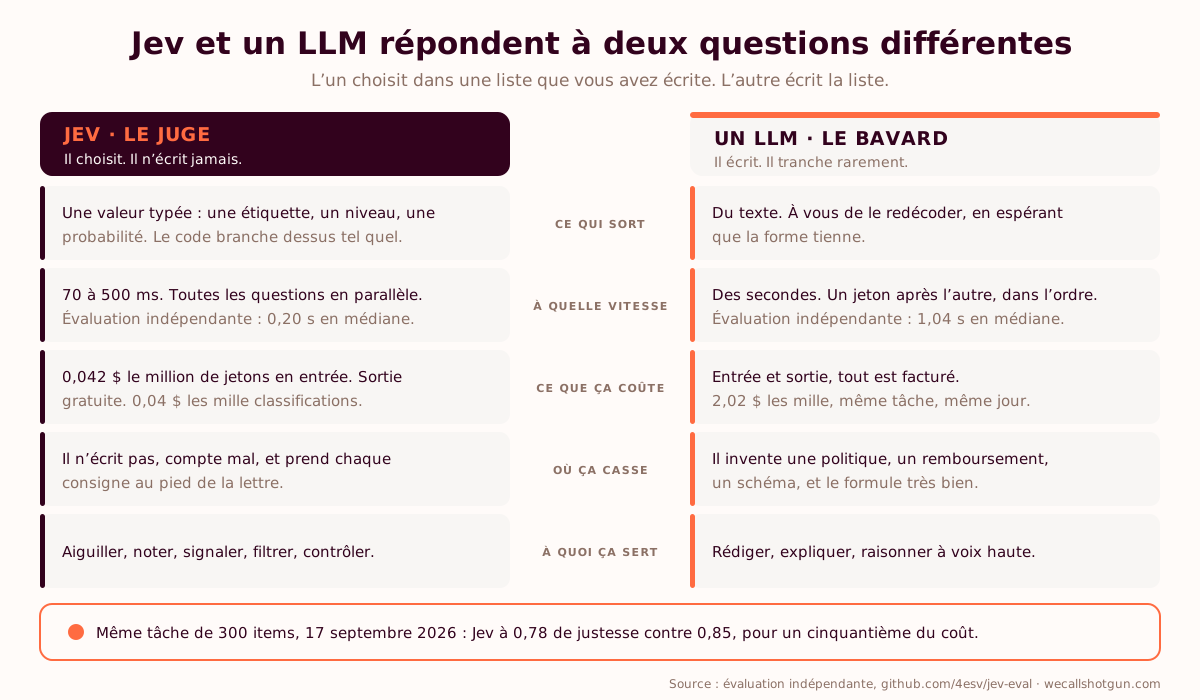
| TypeSafe Jev | Un LLM de pointe | |
|---|---|---|
| Ce qu'il renvoie | Une valeur typée et une distribution de probabilités | Du texte |
| Architecture | Parallèle, toutes les questions à la fois | Autorégressive, un jeton après l'autre |
| Latence annoncée | 70 à 500 ms | Des secondes, qui montent avec la longueur |
| Latence mesurée (17 sept. 2026) | 0,20 s en médiane | 1,04 s en médiane (GPT-5.6 Terra) |
| Facturation | 0,042 $ le million de jetons en entrée, sortie gratuite | Entrée et sortie facturées |
| Coût mesuré, 1 000 appels d'intention | 0,04 $ | 2,02 $ |
| Contexte | 64 000 jetons par requête, environ 32 000 pour l'état et la plus longue question | Des centaines de milliers de jetons |
| Erreur de schéma | Structurellement impossible | Possible à chaque appel |
| Bon pour | Aiguiller, noter, signaler, filtrer, contrôler | Rédiger, expliquer, planifier, appeler des outils |
Les bénéfices, et les chiffres qui les soutiennent
TypeSafe annonce 20 à 200 fois plus rapide et 40 à 400 fois moins cher qu'un modèle de pointe sur du travail décisionnel. Ce sont des chiffres d'éditeur issus de bancs d'essai d'éditeur, et au moins un média a relevé que l'affichage à 445x sur le coût reste testé en interne. Prenez-les comme une hypothèse de départ.
Deux évaluations indépendantes sont tombées dans les trois jours suivant le lancement, et elles servent davantage que le marketing.
La première, publiée le 17 septembre 2026, oppose Jev 1.13.0 à GPT-5.6 Terra sur trois tâches de classification de 300 échantillons chacune. Reconnaissance d'intention sur Banking77 : 0,78 de justesse pour Jev, 0,85 pour Terra. Sentiment sur SST-5 : 0,57 contre 0,59. Polarité sur IMDB : 0,97 contre 0,97. La latence médiane ressort à 0,20 s pour Jev et 1,04 s pour Terra, soit environ cinq fois plus rapide, loin des deux cents. Le coût pour mille appels s'établit à 0,04 $ contre 2,02 $ sur l'intention, 0,01 $ contre 0,64 $ sur le sentiment, 0,02 $ contre 0,85 $ sur la polarité. Le même rapport note que Jev compte environ deux fois plus de jetons en entrée pour un texte équivalent, ce qui rogne l'avantage au jeton.
La seconde, pré-enregistrée et publiée le 18 septembre 2026, ajoute deux références que les comparatifs d'éditeur oublient volontiers. Sur Banking77, un encodeur bge-small gelé surmonté d'une régression logistique obtient 0,933 pour une médiane de 0,01 s, devant GPT-5.6 Terra à 0,875 et Jev à 0,832. Sa conclusion est la phrase que tout acheteur devrait relire : là où des données annotées existent, un encodeur supervisé à 9 ms gagne. Sur CLINC150, Jev atteint 0,870 contre 0,915 pour Terra et 0,795 pour un LLM de classe nano. Les deux verdicts sont enregistrés comme ambigus.
Ce qui résiste à l'examen
Jev est un bon classifieur zéro-shot qui répond en un cinquième du temps et pour environ un cinquantième du coût d'un modèle de pointe, en perdant quelques points de justesse au passage. C'est un arbitrage réel et utile. C'est une promesse plus modeste que celle du billet de lancement, et c'est celle sur laquelle vous pouvez bâtir un budget.
L'autre bénéfice tient à la calibration. TypeSafe entraîne Jev avec ce qu'il appelle RLCD, apprentissage par renforcement pour des décisions calibrées, de sorte qu'un 0,9 signifie quelque chose de proche de « juste neuf fois sur dix » plutôt qu'un chiffre inventé par un modèle de chat pour paraître sûr de lui. C'est ce qui rend une logique de seuil possible, et c'est la partie du produit qui change la conception d'un workflow.
Avant de chiffrer un modèle, chiffrez la décision qu'il remplace.
Lancer le calculateur de ROI IA →Voir comment nous travaillons avec les entreprisesCinq entrées, des données publiées, une fourchette du prudent à l'optimiste. Sans mur d'e-mail. Arrivez en comité budget avec un chiffre plutôt qu'un slide d'éditeur.
Les limites, qui comptent plus que les bancs d'essai
TypeSafe documente neuf faiblesses pour Jev 1.13, ce qui dépasse la franchise de la plupart des fiches modèles. Elles valent d'être listées entières, parce que chacune vient avec un workflow attaché.
- Il lit au pied de la lettre. Jev ne lit rien entre les lignes. Une question composée renvoie du bruit autour de 0,5, donc un jugement par question, formulé exactement.
- Il calcule et compte mal. L'arithmétique reste dans le code, à chaque fois.
- Il trie mal les dates. Même réponse : le code.
- Il est faible sur l'indirection à plusieurs sauts. Si la réponse demande de suivre une référence vers une autre référence, c'est un travail de Système Deux.
- Le contexte inutile le dégrade. Envoyez le message et la politique, plutôt que le fil entier et l'historique du compte.
- Il ne traite pas l'entrée adverse comme hostile par défaut. Il faut le lui demander.
- Il casse sur des consignes contradictoires. Deux règles qui se contredisent produisent un tirage à pile ou face.
- Les probabilités complémentaires ne somment pas forcément à 1,0. Faire l'algèbre sur cette hypothèse se paie.
- Il ne génère aucun texte. Pas une phrase, pas un résumé, pas un objet d'e-mail.
Ajoutez le plafond de contexte : 64 000 jetons par requête, dont environ 32 000 de budget de travail pour l'état et votre plus longue question. Jev n'a ni recherche, ni outils, ni mémoire de votre appel précédent. Ce que vous mettez dans l'état constitue le monde entier qu'il connaît.
La limite la plus tranchante vient des évaluations plutôt que de la documentation. Dans un test tiers rapporté à la mi-septembre 2026, classer 2 000 e-mails frauduleux et légitimes avec une seule question de jugement large place Jev à 62,6 %, loin derrière Claude Haiku 4.5 à 81,3 %. La même tâche de fond, décomposée en cinq questions atomiques dont les pondérations sont calées sur 1 000 exemples annotés puis évaluées sur les 1 000 autres, atteint 95,0 %.
Lisez bien, parce que la lecture facile est fausse. Le 62,6 % n'est pas devenu 95,0 % par magie. Il l'est devenu parce que quelqu'un a fait le travail de casser une question floue en cinq questions nettes et a mis la logique de pondération dans le code, à sa place. Jev récompense ce travail plus qu'un modèle de chat, et sanctionne son absence davantage aussi.
La calibration n'est pas la justesse. Une réponse à forte confiance signifie que le modèle est sûr de sa croyance. Elle ne dit rien de la véracité de cette croyance. Vous devez toujours échantillonner les sorties, mesurer les taux d'erreur contre de vraies étiquettes, et les surveiller dans le temps.
Ce que ça change dans notre façon de travailler avec les LLM
Le vrai basculement est architectural. Depuis deux ans, le schéma par défaut confie tout à un gros modèle : lire, décider, rédiger, appeler des outils. Ce schéma est lent là où il faut être rapide et cher là où il faut être bon marché, et il a laissé beaucoup d'équipes avec la fatigue des modèles qui vient de remplacer un modèle de pointe par un autre pour la même facture.
Jev sépare le travail. Le jugement passe devant. La rédaction passe derrière. Votre code possède ce qui se joue entre les deux.
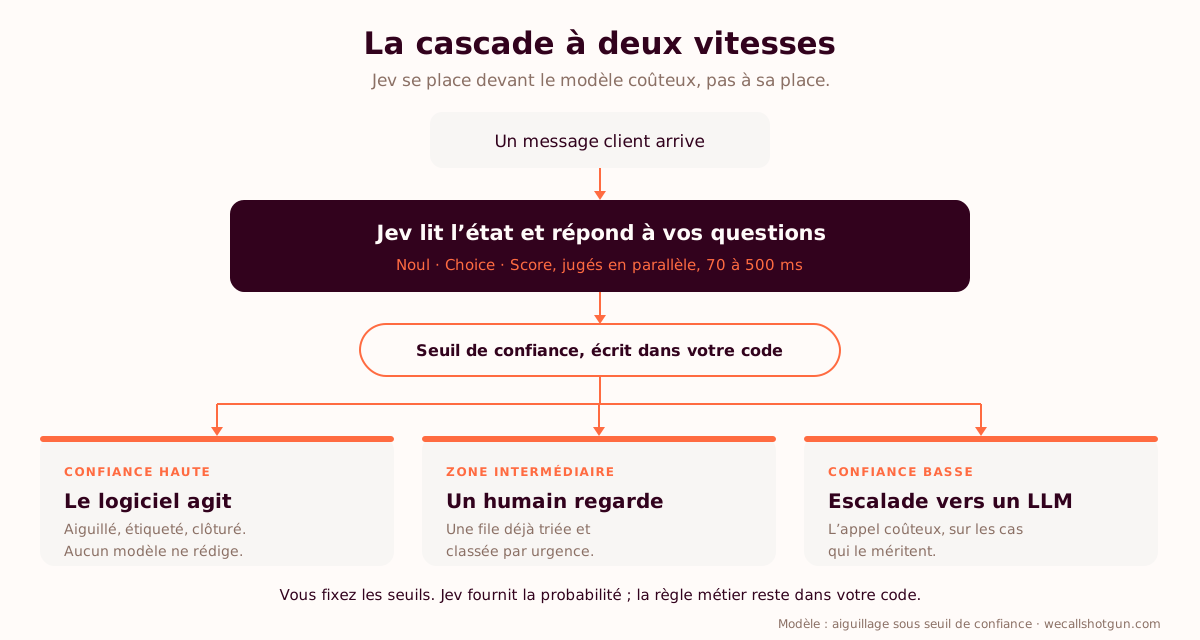
Trois schémas sortent de cette séparation, et les trois tournent déjà quelque part en production.
L'aiguillage sous seuil de confiance. Au-dessus de votre seuil haut, le logiciel agit et rien ne rédige quoi que ce soit. Dans la zone intermédiaire, un humain regarde, une file qui arrive triée et classée. Sous votre seuil bas, la demande monte vers un modèle de raisonnement. Vous choisissez les seuils, donc la règle métier vit dans un fichier que votre équipe peut lire, relire et changer, au lieu de dormir dans un prompt.
L'économie est sans subtilité. Si Jev absorbe les 80 % faciles à 0,04 $ les mille et que seuls les 20 % difficiles atteignent un modèle à 2,02 $ les mille, le coût mélangé baisse d'environ trois quarts. Mesurez votre propre répartition avant de croire ce chiffre sur votre propre trafic.
Des garde-fous aux deux bouts. Un Noul à l'entrée, qui demande si le message entrant ressemble à une injection de prompt. Un second Noul à la sortie, qui demande si le brouillon de réponse promet un remboursement, une remise ou une politique que votre politique réelle ne contient pas. Les deux tournent en moins d'une demi-seconde, seule raison pour laquelle quelqu'un acceptera de les mettre dans le fil d'une conversation en direct. C'est la chose utile la moins chère que la plupart des équipes pourraient livrer ce trimestre.
Une récupération qui filtre avant de dépenser. Notez chaque passage récupéré sur sa pertinence, jetez tout ce qui passe sous la barre, et envoyez un contexte court et propre au modèle coûteux plutôt que vingt passages et une prière. Moins de pourrissement de contexte, factures plus petites, meilleures réponses. Si vous construisez des workflows agentiques, c'est là que la qualité bouge vraiment.
Où ça apparaît au travail
Le tri du support. Catégorie, urgence, niveau d'agacement et drapeau d'escalade, jugés ensemble en un appel de moins d'une demi-seconde. La file qui arrive à votre équipe est déjà triée. Un service client de taille moyenne à 2 000 tickets par mois dépense quelques centimes par mois en classification.
La qualification de leads. Notez un formulaire entrant sur le budget, le calendrier, le pouvoir de décision et le besoin, en quatre questions séparées, combinez-les avec des pondérations que vous maîtrisez, et envoyez la tranche haute vers un humain pendant que le reste part en nurturing. Le fait que les pondérations soient les vôtres change tout : vous pouvez expliquer le score à un directeur commercial sans ouvrir un modèle.
Le criblage fournisseurs et conformité. Passez une checklist de politique en éventail de questions oui/non sur chaque réponse de fournisseur. Signalez celles qui déclenchent une règle. Un humain lit les signalements plutôt que la pile.
Le risque au paiement. Jugez les signaux d'une transaction, validez les propres, retenez les suspectes pour revue. Le budget de latence au moment du paiement fait la contrainte, et cette forme tient dedans.
La modération de contenus et d'annonces. Criblez les nouvelles soumissions pour repérer les attributs manquants et les manquements à la politique avant mise en ligne.
Une réserve sur le recrutement
Le tri de CV est le cas d'usage que tous les éditeurs démontrent et celui qui porte le plus de droit. Sous le règlement européen sur l'IA, une IA utilisée pour filtrer des candidatures ou évaluer des candidats entre en catégorie à haut risque, avec des obligations de transparence, de supervision humaine, de journalisation et de tests de biais. Un classifieur rapide, calibré et peu cher facilite le criblage de milliers de personnes, et facilite tout autant de le faire illégalement. Si vous y allez, allez-y avec votre équipe juridique, pas devant elle.
Si vous ne codez pas, voilà ce qui change vraiment
Vous n'ouvrirez jamais Jev pour taper dedans. Pas de fenêtre de chat, pas de champ de prompt, aucun endroit où coller un document. C'est une pièce que des ingénieurs installent dans un logiciel, comme personne chez vous ne s'est jamais connecté directement à une base de données.
Ce qui change pour vous apparaît dans les outils que vous utilisez déjà.
Le bot arrête d'inventer la politique maison, parce que quelque chose vérifie chaque brouillon contre la vraie politique avant l'envoi. Votre file arrive triée par degré d'énervement plutôt que par heure d'arrivée. Le lead qui allait dormir une journée atteint un commercial en quelques secondes. La ligne IA du budget de l'an prochain arrête de grimper au rythme de l'usage, parce que le juge bon marché absorbe le volume et que le rédacteur coûteux traite les exceptions.
Si un éditeur vous vend ça, trois questions tranchent l'essentiel. Que se passe-t-il quand le modèle hésite, et qui le voit. Qui a écrit les seuils, et pouvons-nous les changer sans une mise en production. Que mesure-t-on, contre quelle baseline, à partir de quand. Un éditeur qui répond bien aux trois mérite un pilote. Un éditeur qui répond par une courbe de latence vous vend un banc d'essai.
Là où We Call Shotgun intervient
Un modèle plus rapide n'a jamais changé la façon dont une équipe travaille. Nous avons vu des entreprises acheter la licence, organiser le webinaire de lancement, et découvrir six mois plus tard que les trois mêmes personnes s'en servent et que le workflow en dessous n'a pas bougé d'un centimètre. L'outil n'a jamais été le problème. Personne ne leur a appris à conduire.
Jev creuse cet écart, parce qu'il est invisible. Il n'y a aucune interface à adopter, donc la seule façon dont il crée de la valeur, c'est que quelqu'un ait cartographié un workflow, trouvé les décisions qu'il contient, et reconstruit le chemin autour d'elles. C'est du travail, et c'est le travail que nous faisons.
À quoi ressemble une mission sur ce sujet précis. Nous prenons un workflow dont votre équipe se plaint et nous le chronométrons tel qu'il tourne aujourd'hui : combien de temps un ticket attend, combien de mains le touchent, où il cale. C'est la baseline, et sans elle tout chiffre qui suit n'est qu'une histoire. Nous sortons ensuite les décisions cachées dedans, celles qu'une personne prend en cinq secondes et qualifie d'évidentes, et nous les trions. Certaines sont du code. Certaines ont la forme d'un Jev. Certaines demandent un modèle capable de rédiger. La plupart demandent une personne, et l'intérêt de l'exercice est de donner à cette personne une file plus courte et un arbitrage plus clair.
Nous construisons alors un pilote costaud sur un workflow, avec des seuils que votre équipe fixe et une boucle de revue que votre équipe tient, puis nous remesurons le temps de cycle. S'il a bougé, on élargit. Sinon, nous le disons et vous aurez dépensé un sprint plutôt qu'une année. Nous sommes agnostiques en outils, de ChatGPT Enterprise à Microsoft Copilot, Google Gemini et Claude, et la même posture vaut pour un modèle de décision : ce qui nous intéresse, c'est que le workflow ait accéléré, très peu le logo dessus. Pour les équipes qui arbitrent leurs achats, notre guide sur quelle formule IA pour quelle équipe traite la décision au niveau du siège.
Trouvez les décisions cachées dans un workflow, et ce qu'elles vous coûtent aujourd'hui.
Réserver un appel workflow de 20 minutes →Passer le diagnostic de maturité IA gratuitVingt minutes, un workflow, aucun deck. Vous repartez avec une baseline qui vaut la peine d'être mesurée.
Questions fréquentes
TypeSafe Jev, c'est quoi ?
Jev est un modèle de décision de TypeSafe AI, lancé le 15 septembre 2026. Il lit l'état d'une application et renvoie des décisions typées et calibrées : une probabilité oui/non (Noul), une option prise dans une liste de 255 au maximum (Choice), ou une position sur une échelle de 2 à 10 niveaux (Score). TypeSafe parle de modèle « Système Un », au sens où il juge immédiatement au lieu de raisonner par étapes.
En quoi Jev diffère-t-il d'un LLM ?
Un LLM génère du texte jeton par jeton et peut renvoyer une réponse malformée. Jev renvoie directement une valeur typée, en parallèle, sans étape de génération, donc la forme de la sortie est garantie et votre code branche dessus sans rien redécoder. La contrepartie : Jev n'écrit rien, ni e-mail, ni résumé, ni code.
Combien coûte Jev ?
TypeSafe facture 0,042 $ le million de jetons en entrée, la sortie n'étant pas comptée. Une évaluation indépendante du 17 septembre 2026 mesure 0,04 $ les mille classifications d'intention, contre 2,02 $ pour GPT-5.6 Terra sur la même tâche. Ce rapport relève aussi que Jev compte environ deux fois plus de jetons en entrée pour un texte équivalent : modélisez le coût sur vos propres charges.
Jev est-il rapide ?
TypeSafe annonce 70 à 500 ms par appel, toutes les questions d'une requête étant jugées en parallèle. Les tests indépendants du 17 septembre 2026 mesurent une médiane de 0,20 s contre 1,04 s pour GPT-5.6 Terra, soit environ cinq fois plus rapide. L'annonce de 20 à 200 fois de l'éditeur n'a pas été reproduite par un tiers.
Jev peut-il remplacer ChatGPT ou Claude ?
Non, et il n'est pas vendu comme un remplacement. Jev prend le jugement. Un modèle de pointe prend la rédaction, la planification et l'appel d'outils. L'architecture courante met Jev devant comme filtre et comme seuil, avec un modèle de pointe derrière sur les cas qui le méritent.
Qu'est-ce que Jev ne sait pas faire ?
Il ne génère aucun texte, calcule et compte mal, trie mal les dates, peine sur le raisonnement à plusieurs sauts et lit les consignes au pied de la lettre. Il n'a ni recherche, ni outils, ni mémoire entre deux appels. Son plafond de contexte est de 64 000 jetons par requête, dont environ 32 000 disponibles pour l'état et la plus longue question.
Jev est-il assez juste pour la production ?
Tout dépend de la façon dont vous formulez les questions. Une seule question large sur un jeu de classification d'e-mails donne 62,6 % en test tiers, derrière Claude Haiku 4.5 à 81,3 %. La même tâche découpée en cinq questions atomiques avec pondérations calées atteint 95,0 %. Là où vous disposez déjà de données annotées, un encodeur supervisé obtient 0,933 sur Banking77 pour une médiane de 0,01 s, devant Jev et un modèle de pointe. Testez sur vos propres données avant de vous engager.
Faut-il être développeur pour utiliser Jev ?
Oui. Jev n'a ni interface ni fenêtre de chat. C'est une API que des ingénieurs appellent depuis une application. Les équipes non techniques le vivent comme un logiciel qui aiguille, note et signale plus vite et moins cher qu'avant.
Nous montons à la place du passager pour ce problème précis
Nous sommes We Call Shotgun, un cabinet d'adoption de l'IA fondé par ses dirigeants, actif au Royaume-Uni et en France. Nous sommes agnostiques en outils, de ChatGPT Enterprise à Microsoft Copilot, Google Gemini et Claude, et chaque mission commence par une baseline et se termine par un changement mesuré du temps de cycle sur de vrais workflows. 1 500+ professionnels accompagnés, 50+ entreprises, 4,98/5 de note moyenne. Interventions à partir de 3 500 £.
Passer le diagnostic de maturité IA gratuit Réserver un appel gratuit de 20 minutesSources et lectures
- TypeSafe AI, documentation Jev : les primitives, le modèle d'état, la tarification et le cadre « Système Un »
- TypeSafe AI, Jev 1.13 jaggedness : les neuf faiblesses documentées, publiées par l'éditeur
- 4esv/jev-eval : évaluation indépendante de Jev 1.13.0 face à GPT-5.6 Terra, 17 septembre 2026, avec justesse, calibration, latence et coût par tâche
- ickma2311/jev-baselines-eval : évaluation pré-enregistrée du 18 septembre 2026 face à un LLM de classe nano, un LLM de pointe et un encodeur supervisé, sur Banking77 et CLINC150
- XenoSpectrum et The Daily Brief : les résultats de 62,6 % en question unique et 95,0 % en décomposition sur le jeu de 2 000 e-mails
- TS2 et pearpages : la levée de 40 M$, et les annonces qui restent testées par l'éditeur seul
- Référence communautaire sur Jev : primitives, contraintes, formes de décision et schémas d'implémentation